
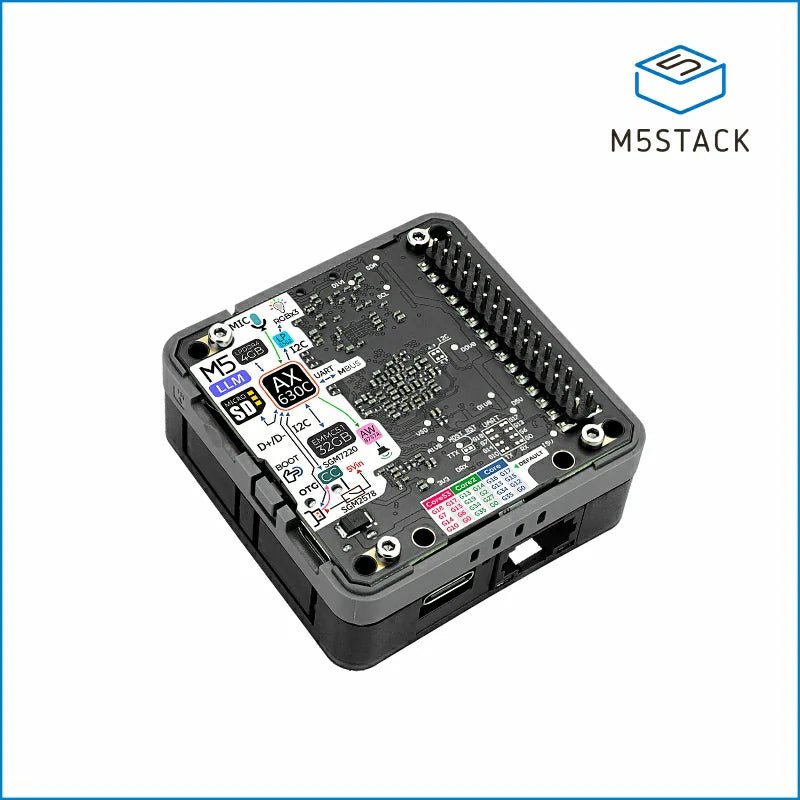
Kit de inferencia de modelos de lenguaje pequeños (hasta ~1,5B parámetros) en el edge — no es comparable a LLMs de nube ni a modelos locales de 7B+.
Gestionada por Artil en Ecuador, sin enviar el equipo al exterior.
Stock en Ecuador o importación: te lo confirmamos en la proforma.
Proforma lista para el pliego de SERCOP, o factura local con IVA.
Te acompañamos en la puesta en marcha y después de la compra.
El M5Stack LLM Module Kit usa el chip AX630C de Axera Semiconductor (fabricación TSMC 12nm), un SoC de IA/visión en el borde con CPU dual Cortex-A53 y motor NPU AXNeutron 4.0 (3,2 TOPS INT8 / 12,8 TOPS INT4 en pico). A pesar del nombre «LLM», el chip está pensado para modelos de lenguaje pequeños y cuantizados — el modelo preinstalado es Qwen2.5 de 0,5B parámetros, y el repositorio oficial de modelos para este hardware no supera ~1,5B parámetros. No hay soporte oficial para modelos de 7B+.
El nombre «LLM» es engañoso frente al uso habitual del término: este kit corre modelos pequeños cuantizados (≤1,5B parámetros) de forma local, útil para Q&A simple o comandos de voz de dominio acotado — no es comparable a LLMs de nube ni a despliegues locales de 7B+ parámetros.
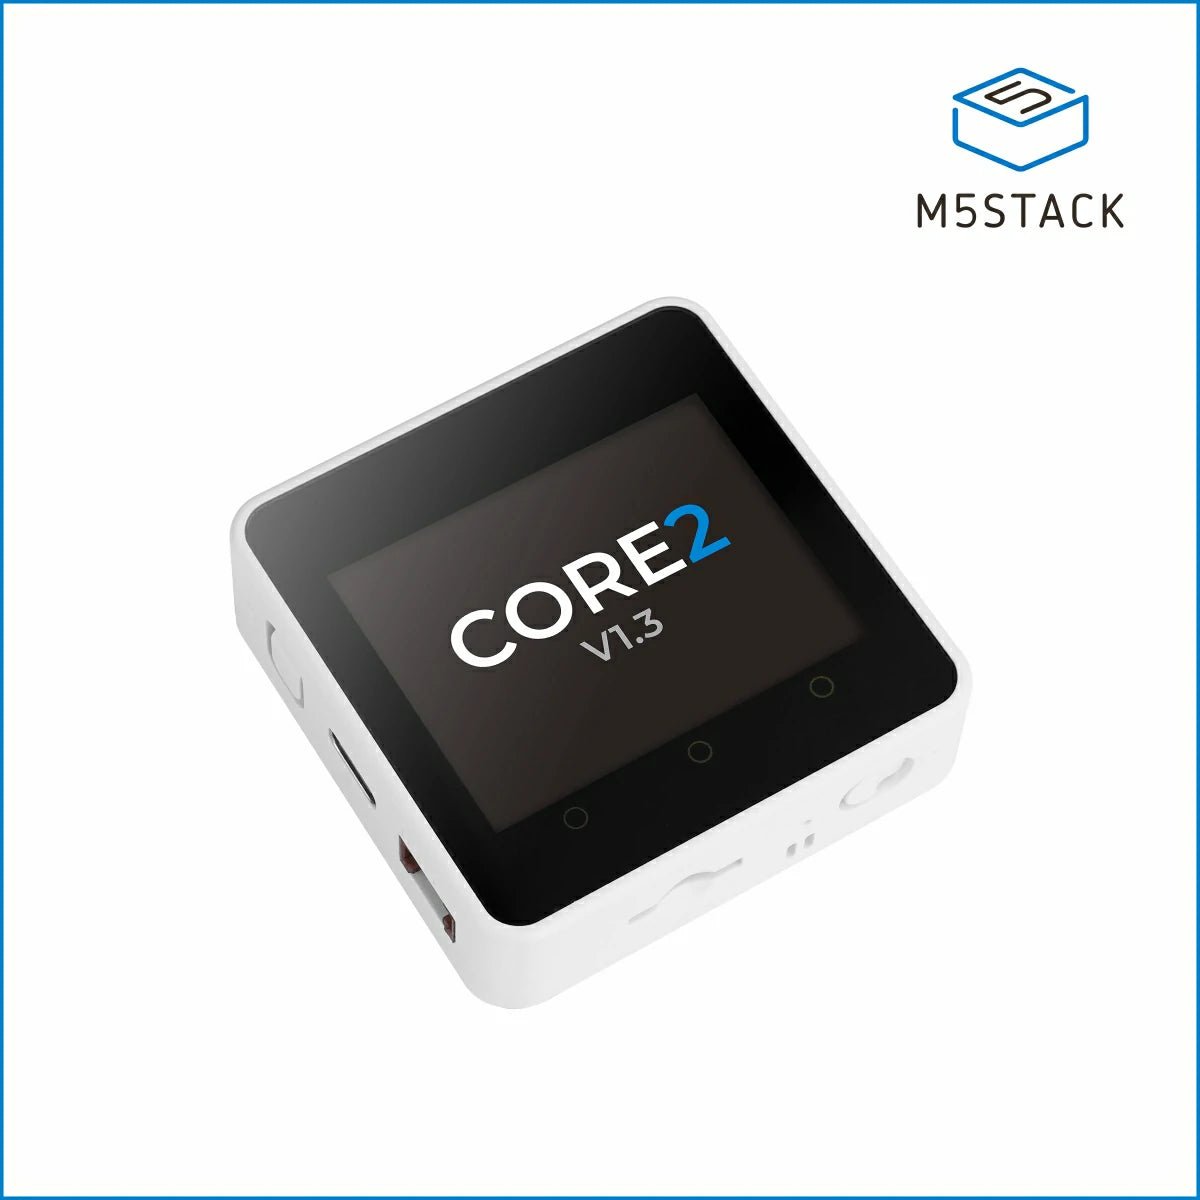
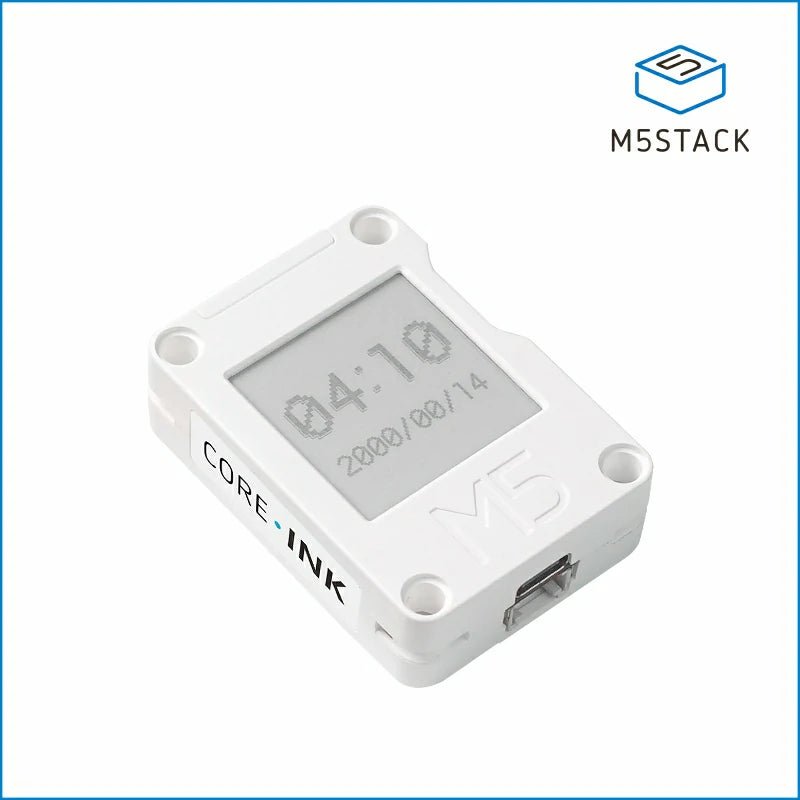
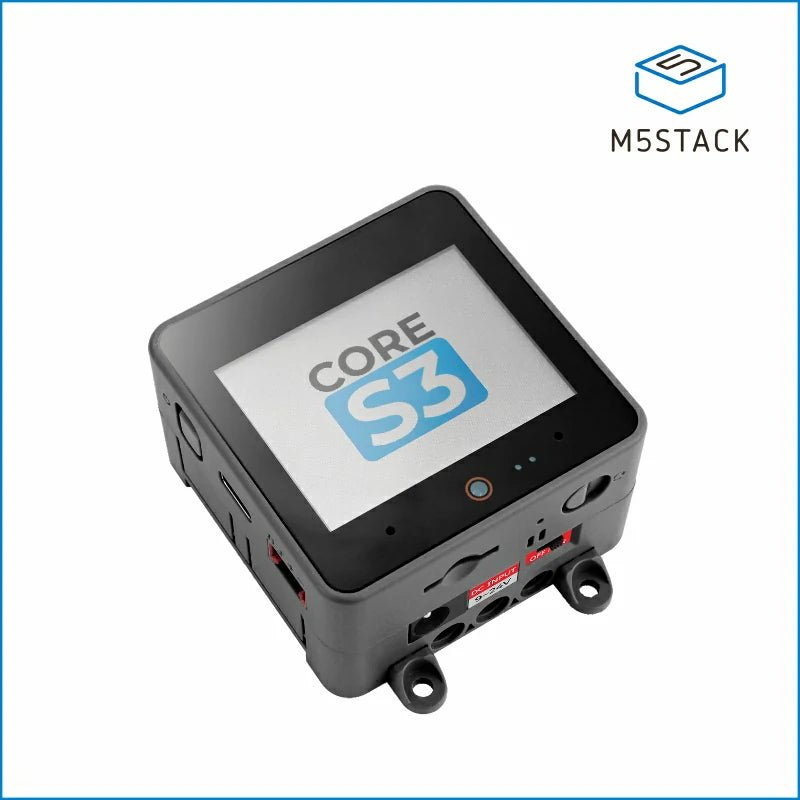
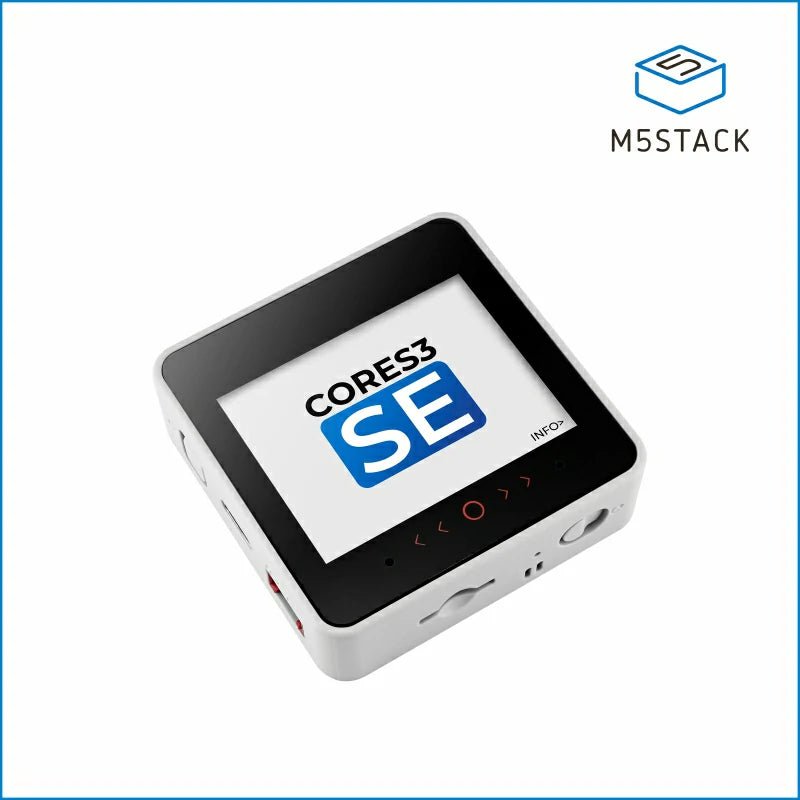
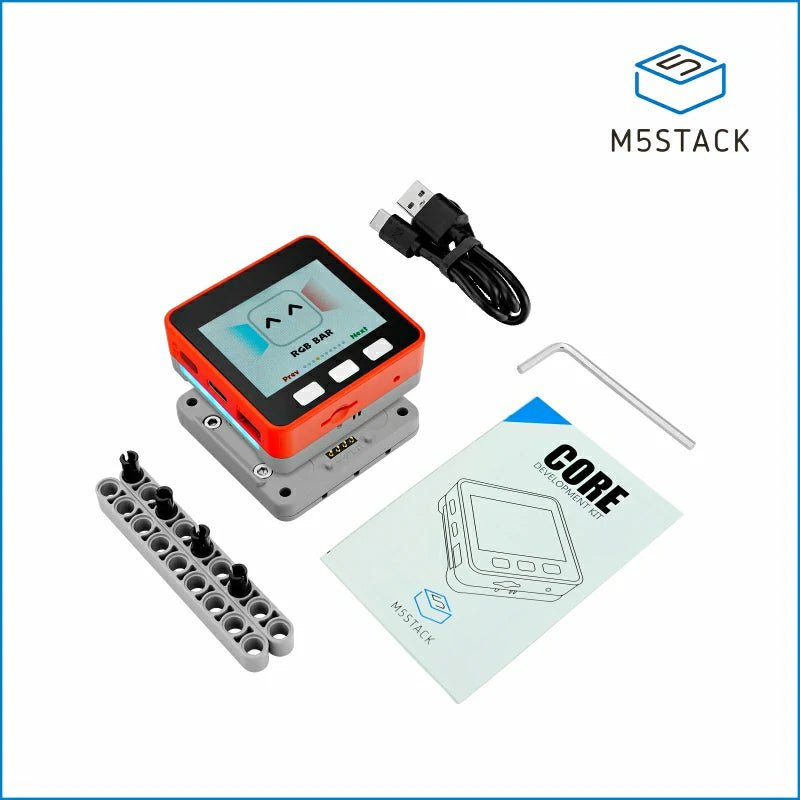
Cada equipo se cotiza según tu aplicación y tu forma de compra.
Por este formulario o por WhatsApp, en menos de un minuto.
Precio, plazo de entrega y especificaciones listas para tu pliego.
Te acompañamos en la puesta en marcha y quedamos como tu soporte local.